
Kimi 新模型 K2.8 Preview 全量上线!综合性能逼近 K3!
Kimi 新模型 K2.8 Preview 全量上线!综合性能逼近 K3!Kimi K2.8 Preview 编程模型全量上线 Kimi Code,支持 1M 超长上下文并向所有会员档位开放,综合性能接近 K3,默认采用 Max 思考档位,编码和智能体能力较 K2.7 Code 有所提升。
来自主题: AI资讯
9271 点击 2026-09-11 21:23

 搜索
Kimi K2.8 Preview 编程模型全量上线 Kimi Code,支持 1M 超长上下文并向所有会员档位开放,综合性能接近 K3,默认采用 Max 思考档位,编码和智能体能力较 K2.7 Code 有所提升。
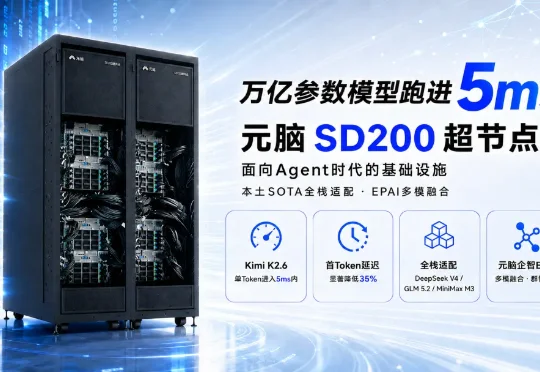
浪潮信息宣布,元脑SD200超节点AI服务器率先完成主流领先开源大模型Kimi K2.6、DeepSeek V4、GLM 5.2、MiniMax M3等的高性能优化,并在Kimi K2.6万亿参数大模型上实现Token生成时间快达4.77ms,为Agent场景应用的高效运行提供强大算力支撑。
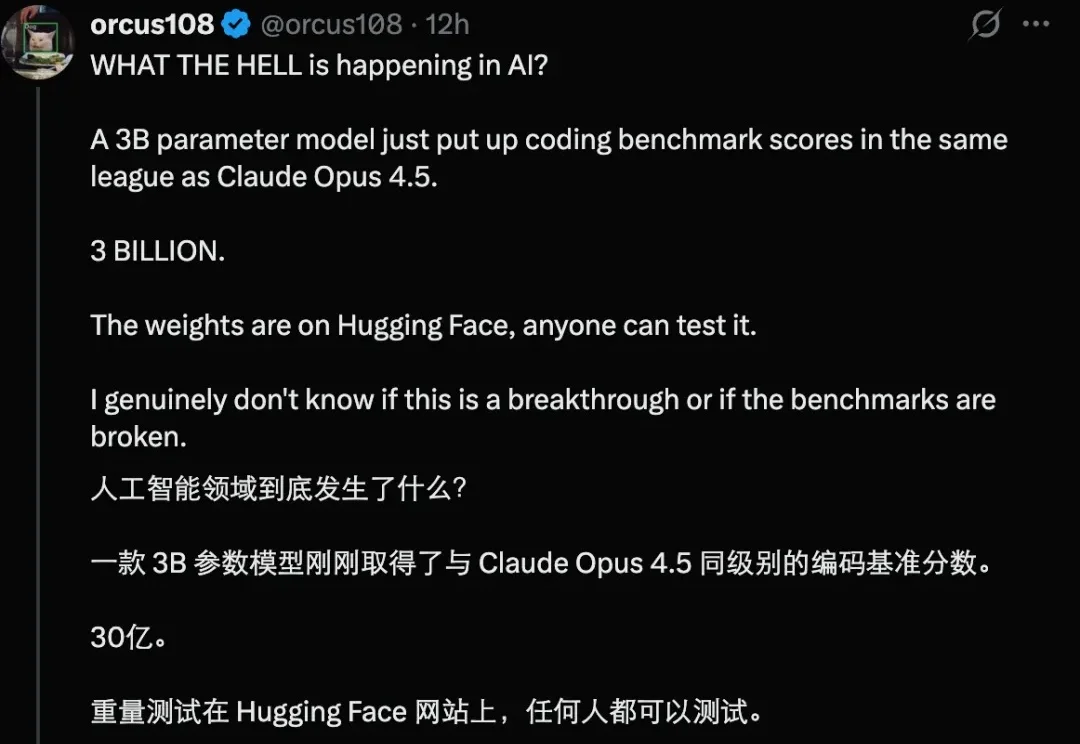
最近几天,一个 3B 的小模型在 X 上火了,因为在一些难度可验证的推理任务上(比如编程),它进入了 Gemini 3 Pro、GPT-5 high、Claude Opus 4.5、GLM-5、Kimi K2.5 等前沿模型的性能区间,而它的体积远小于这些模型。
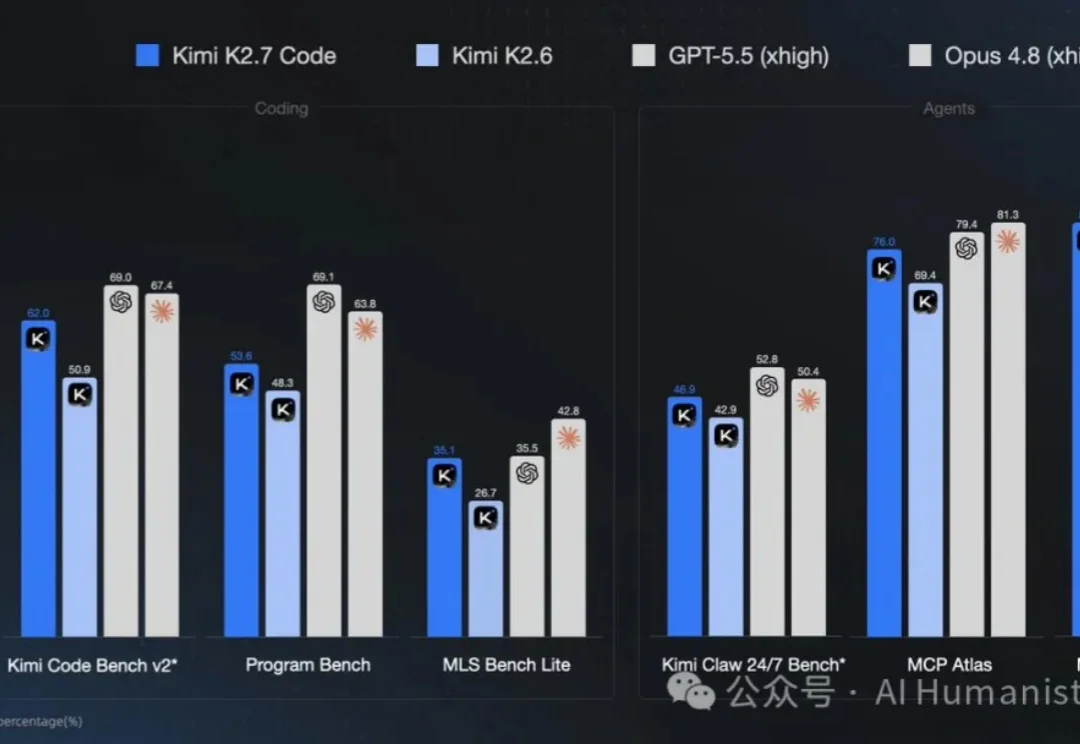
昨天 Kimi K2.7 Code 高速版 上线了,我上手试了下,最大的感受就一个字:快。
朋友们,Kimi 又更新了。
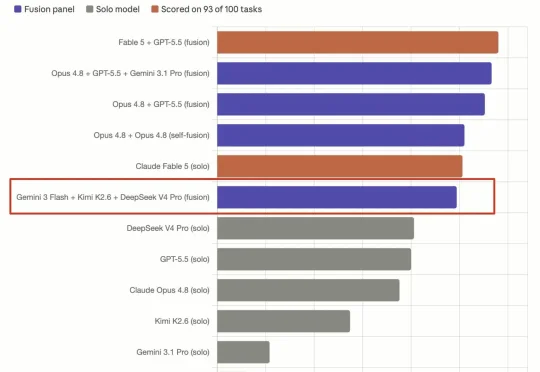
最新测试显示,模型抱团后实力明显升级:Opus 4.8+GPT-5.5>Fable 5;Kimi K2.6+ DeepSeek V4 Pro+Gemini 3 Flash=Fable 5。能力追上了,开销还减半。根据官方定价,相比Fable 5,Kimi K2.6+ DeepSeek V4 Pro+Gemini 3 Flash这套平价阵容,成本降幅接近80%。
今天,月之暗面发布并开源Kimi K2.7 Code编程模型,参数量达1.1万亿,提供256K上下文窗口。这一模型重点提升了长上下文编程场景的指令遵循能力、长程编程任务的性能表现,并且大幅改善了在长程任务中的过度思考倾向,平均token消耗减少30%。
从去年开始做这个账号以来,我其实写过不少测模型的文章。我相信也有很多朋友是因为看了我测评的文章关注我的。但从过年之后,真的就很少写模型评测的文章了。主要是我写文章的速度甚至一度跟不上模型发布的速度了。
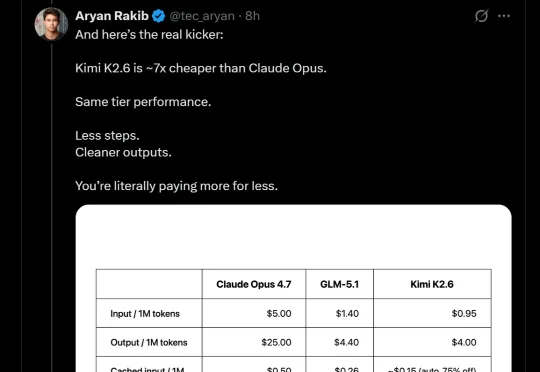
Claude Design前脚刚暴击完设计行业,结果后脚自己就被暴击了。出手的是来自中国的Kimi K2.6。什么??你跟我说小克专门为设计推出的工具,竟然没打过Kimi最新通用旗舰模型??
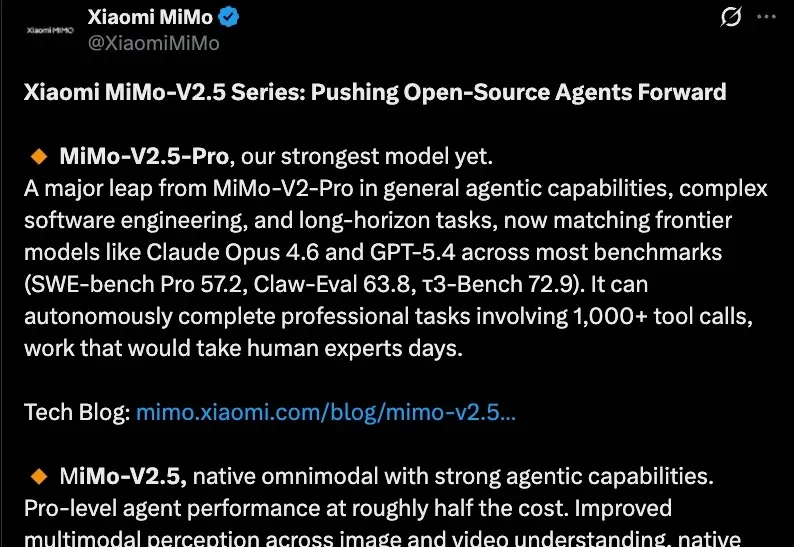
小米大模型时隔一月能力飙涨,比Kimi K2.6省42% Token。